Бизнес-КлассЕвгения Васильевна
Евгения Васильевна
Буглакова
Руководитель Digital R&D Lab «Бизнес-Класс»

Графическая нода и Studio
в проекте «Бизнес-Класс × ИТ-Куб»
В агентстве собрали вычислительный стенд для работы с изображениями: от генерации по описанию до правок, сохранения версий и первого эксперимента обучения. Управлять этим процессом можно через Studio — веб-интерфейс с редактором, библиотекой и очередью заданий.
Партнёрская лаборатория развивается с сентября 2026 года. Для следующего шага нужны практические ответы: какие модели помещаются на доступном оборудовании, сколько приходится ждать, где возникают ошибки и что можно предложить участникам для самостоятельного эксперимента.
Графическую ноду собрали в агентстве, чтобы пройти этот путь на собственных задачах. Здесь проверяют модели и режимы работы, собирают пользовательский инструмент и сохраняют материалы опытов. Часть экспериментов предстоит повторить в ИТ-Кубе — с понятной постановкой задачи, исходными условиями и сравнением результатов.
Для агентства стенд помогает исследовать применение ИИ в визуальной работе. Для партнёрского проекта он становится примером системы, которую можно разобрать по шагам: оборудование, модель, интерфейс, результат и его оценка.
Этот этап готовит техническую и методическую основу для маршрутов лаборатории «Визуальная упаковка» и «Протокол ответственного ИИ». Их образовательная апробация с участниками предстоит отдельно.
Руководитель Digital R&D Lab «Бизнес-Класс»
Руководитель ИТ-Куба Новочеркасска
Генератор + декодер
Энкодер / помощник
Обучение — отдельный режим
Память карт раздельная. 48 ГБ RAM на стороне хоста.
Интерфейс · авторизация
История версий · постоянное хранение
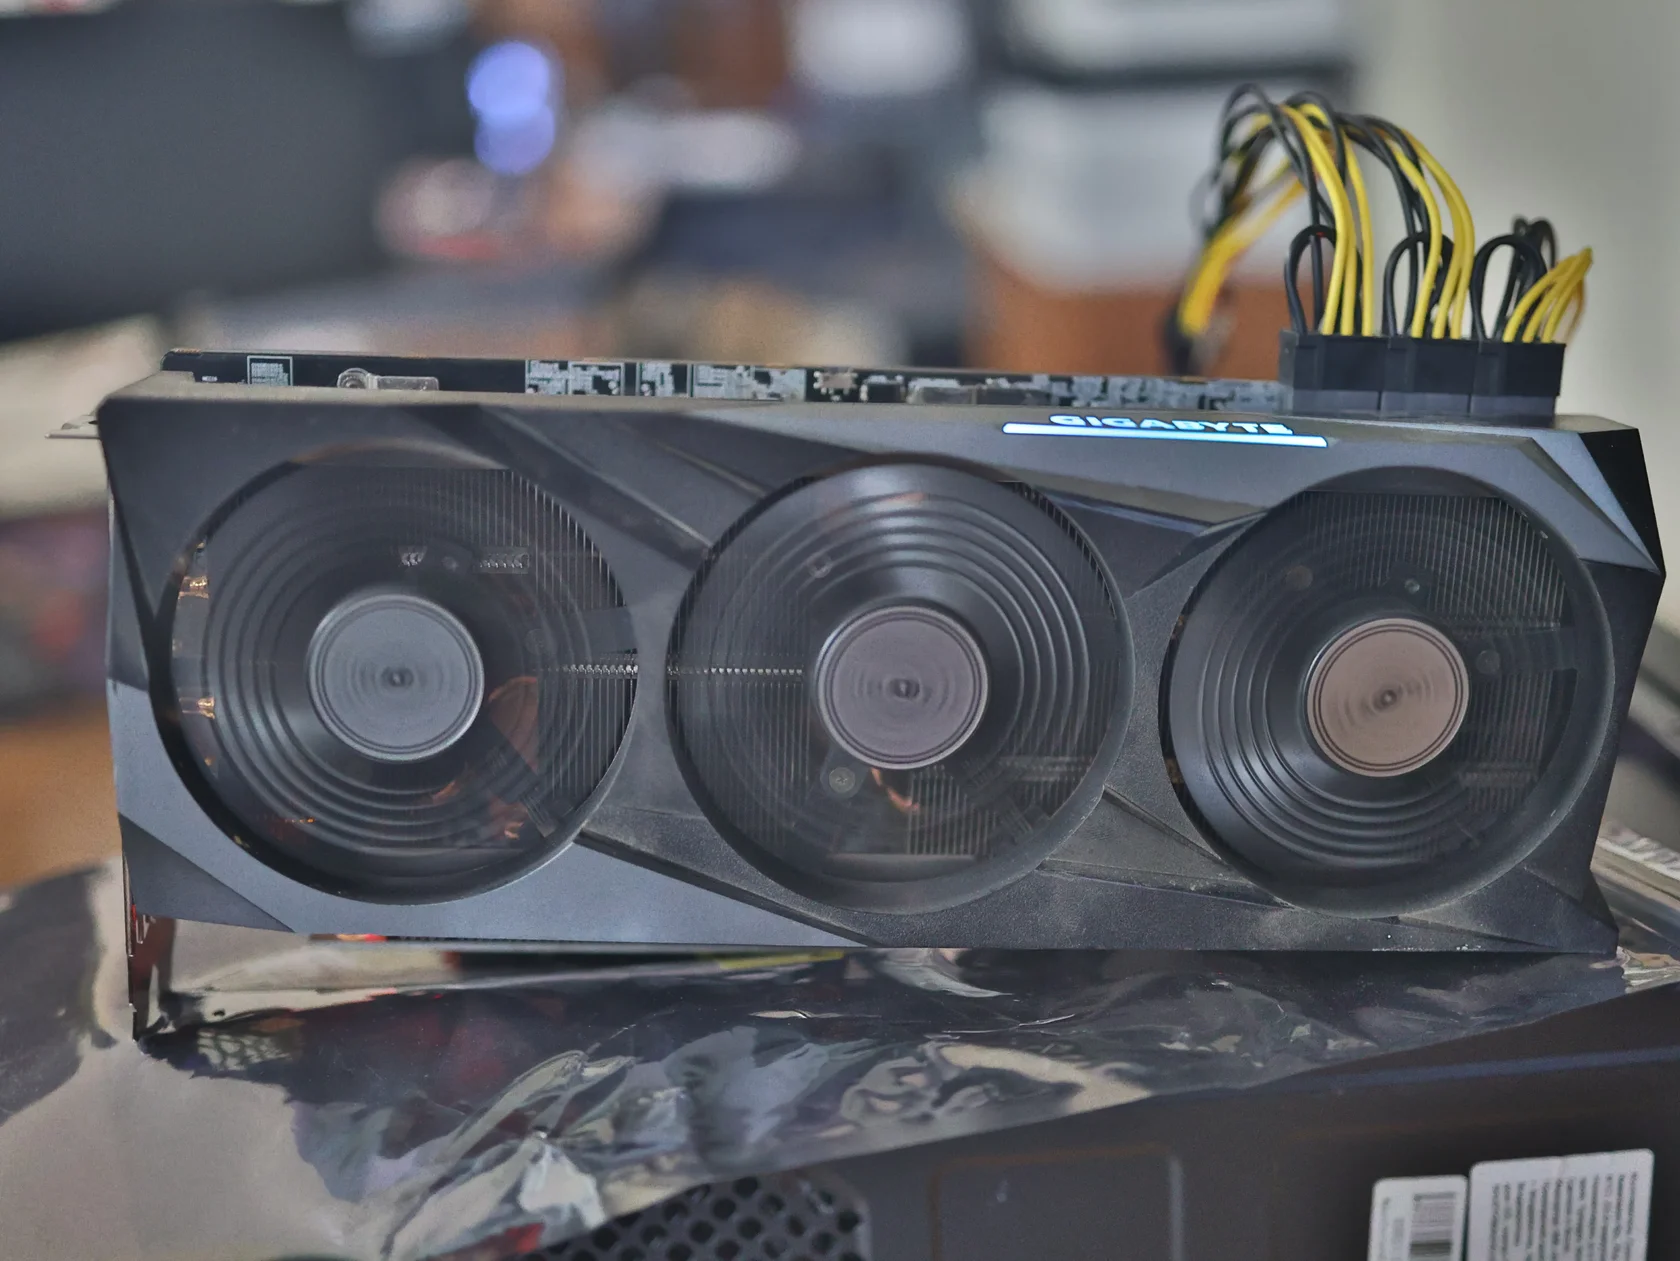
Нода — это компьютер, который выполняет вычислительную часть задачи. В текущей конфигурации установлены две AMD Radeon RX 6900 XT по 16 ГБ. Работа между ними распределена: одна карта создаёт изображение, другая обслуживает подготовку запроса и связанные модели.
| Компонент | Конфигурация стенда |
|---|---|
| Видеокарты | 2 × AMD Radeon RX 6900 XT, по 16 ГБ |
| Оперативная память | 48 ГБ DDR4 |
| Процессор | Intel Pentium Gold G5420 |
| Материнская плата | ASUS PRIME B365-PLUS |
| Накопители | SSD Apacer AST280 240 ГБ и HDD Seagate 500 ГБ |
| Питание | Thermaltake Madrid 850W |
| Установка | Открытый стенд, ленточный райзер PCIe 3.0 x16 |
Память двух видеокарт остаётся раздельной: размер модели и распределение вычислений приходится учитывать при выборе режима работы. Генератор с весами BF16 и декодер изображения размещаются на первой карте; текстовый энкодер с квантованием Q4_K_M - на второй. Расширение запроса и обучение используют вторую карту по правилам освобождения памяти. Подробная схема и ограничения платформы приведены в приложении.
Интерфейс Studio, авторизация, библиотека и постоянное хранение работают на основном сервере агентства HP ProLiant ML350p Gen8, далее - ML350. Нода отвечает за вычисления моделей. Такое разделение позволяет развивать редактор и хранить результаты отдельно от графического стенда.
Первая RX 6900 XT выполняет генерацию и декодирование изображения. Вторая обслуживает подготовку запроса и текстовый энкодер; в отдельных исследовательских запусках на ней выполняется обучение. Память каждого устройства управляется отдельно.
Сервер ML350 обслуживает веб-интерфейс, авторизацию, библиотеку, версии и постоянные архивы. Для повторения всей системы со Studio учитывают и эту часть инфраструктуры.
| Задача | Модель и вычислительный стек |
|---|---|
| Создание и генеративная правка | Рабочий distilled FLUX 3 Image Klein, веса генератора BF16, stable-diffusion.cpp с Vulkan |
| Кодирование текста для генератора | Qwen3-VL-4B Q4_K_M, родной энкодер в составе цепочки stable-diffusion.cpp |
| Развитие запроса | Специализированный FLUX 3 Image Klein PUP Q6_K, llama.cpp с Vulkan; пользователь просматривает и применяет предложение |
| Декодирование изображения | FLUX.2 VAE на первой карте, обработка тайлами размером 256 |
| Обучение LoRA | Отдельная среда PyTorch 2.9.1 + ROCm 6.4, FLUX 3 Base BF16, обучаемые параметры и AdamW FP32 |
| Ранние опыты редактирования | Qwen Edit, включая опыт EasyCache 15 ноября; результаты относятся к тому эксперименту |
Генерация и помощник используют Vulkan; ROCm задействован в отдельной среде обучения. Это разные программные цепочки. Дополнительный анализатор и проверяющий Qwen3-VL 4B выведен из рабочей цепочки 19 ноября; родной текстовый энкодер сохранён.
Проверенное обучение на RX 6900 XT относится к закреплённой среде и профилю. Для переноса на другое оборудование нужно заново проверить совместимость пакетов, операции обучения и доступную память.
Модель распределена по компонентам. Полный генератор BF16 работает на первой карте; второй карте передаётся отдельный текстовый энкодер с квантованием Q4_K_M. Декодер изображения работает тайлами. Используются mmap и выгрузка части данных в оперативную память хоста.
| Компонент | Размещение и управление памятью |
|---|---|
| Генератор DiT BF16 | Первая RX 6900 XT; веса генератора не объединены с памятью второй карты |
| VAE | Первая карта; тайлы 256 ограничивают размер одновременно обрабатываемой области |
| Текстовый энкодер Q4_K_M | Вторая RX 6900 XT; после замены карты разрешённый бюджет энкодера поднят до 14 ГиБ. Это потолок, а не постоянное потребление |
| PUP Q6_K | Вторая карта; перед следующим запуском энкодера PUP выгружается. Одновременное размещение всех моделей не предполагается |
| Обучение Base LoRA | Вторая карта в отдельном режиме с уступкой памяти; в пилоте 22 ноября PyTorch reserved достигал 15,164 ГиБ |
| Данные хоста | 48 ГБ RAM; предрассчитанные представления и промежуточные данные хранятся отдельно от VRAM |
Вместимость зависит от разрешения, длины описания, референсов, настроек внимания и профиля обучения. Одной надписи «2 × 16 ГБ» недостаточно для повторения опыта. Перед переносом нужны закреплённые версии программ, хэши весов, параметры запуска и проверка соответствия ролей физическим картам.
Pentium Gold G5420 ограничивает запас для обработки данных и совместимость готовых программ: у него нет AVX, поэтому native-движки собирали с SSE4.2. Длительная компиляция на ноде уже потребовала переноса сборки на сервер. Эти ограничения стоит учитывать при повторении стенда.
При этом процессор не оказался главным ограничением одного измеренного режима генерации 11 ноября. У повторного кадра Z-Image-Turbo средняя загрузка CPU по машине составляла 6,29%, самого занятого логического ядра - 16,84%, GPU - 94,05%. Это один запрос раннего профиля; вывод нельзя переносить на нынешний FLUX, подготовку больших наборов данных или обучение.
Для текущей цепочки нужен отдельный профиль времени: подготовка данных, кодирование, пересылки, GPU-расчёт и сохранение. Решение об обновлении CPU следует принимать по этим замерам. Обещать рост скорости всей Studio после одной замены процессора оснований пока нет.
У первой карты фактический путь PCIe Gen3 x16, у второй - Gen3 x4. Это важно при загрузке моделей и передаче данных. Возможность постоянно держать нужные компоненты в памяти уменьшает число повторных загрузок, но не устраняет ограничение интерфейса.
Эффект перехода на другую платформу для полного рабочего сценария пока не измерен. Утверждение о конкретном выигрыше потребует сравнения при одинаковых моделях, данных и настройках.
У каждой RX 6900 XT собственные 16 ГБ. В описанной системе задачи распределяются между картами; наличие двух GPU само по себе не даёт модели единый пул 32 ГБ. При выборе модели учитывают, какие её части и рабочие данные должны находиться на каждой карте.
Для сравнения сохраняли задания, параметры и полученные изображения. Проверяли, сколько занимает работа, соблюдается ли описание и что происходит с деталями: лицами, руками, материалами и надписями. При изменении режима возвращались к тем же заданиям и сопоставляли результаты.
Один из ранних запусков большой модели дал изображение примерно за 28 минут. Для интерактивной мастерской такой режим оказался неудобным: оставшиеся девять заданий серии отменили. Другие модели и настройки проверяли отдельно, подбирая подходящий режим для конкретной задачи.
Аппаратная часть тоже потребовала отладки. В первых нагрузках температура горячей точки GPU достигала 112–113 °C. Задания остановили; в дальнейшую работу включили контроль температуры, управление вентиляторами и пороги остановки.
В LoRA-пилоте 22 ноября мониторинг зафиксировал максимумы 76 и 89 °C на двух картах при вентиляторах около 90%. Температурных предупреждений и остановок в этой серии не было. Пилот занял около 67 минут вместе с паузами и проверками; длительную эксплуатацию нужно проверять отдельно.
Путь к рабочему инструменту складывался из таких решений: запустить, измерить, посмотреть изображение и определить, что менять дальше.
| Период | Что произошло |
|---|---|
| Сентябрь 2026 | Началось партнёрство и развитие учебно-проектной лаборатории |
| 11–13 ноября | Подготовили систему, запустили модели на физическом оборудовании, увеличили RAM до 48 ГБ, сравнили режимы генерации и правок |
| 15–17 ноября | Проверили ускорения, отклонили режим с артефактами, развернули Studio и совместили подготовку следующего задания с генерацией текущего |
| 18–19 ноября | Развили работу с коллекциями, фоном, очередью и версиями; установили вторую RX 6900 XT |
| 22 ноября | Проверили исправление сообщения о сохранении и завершили LoRA-пилот кириллицы |
Графическая нода находится в агентстве. Три многокарточных узла на площадке ИТ-Куба относятся к стартовому парку партнёрской лаборатории и описаны на её основной странице.
Проведены отдельные функциональные и сравнительные испытания. В LoRA-пилоте 22 ноября, занявшем около 67 минут с паузами и проверками, мониторинг зафиксировал максимумы 76 и 89 °C; при вентиляторах около 90% температурных предупреждений и остановок не было.
Суточная непрерывная работа и полная проверка восстановления после отказов этими опытами не подтверждены. Это граница проведённых испытаний. Следующий длительный тест должен включать нагрузку, температуры, ошибки PCIe, время ответа пользователям и восстановление сервисов.
26:04 → 23:11 за 10 заданий.
Все десять PNG совпали побайтово.
Медиана трёх контрольных заданий.
Заметные артефакты — на всех трёх.
Пока одна видеокарта создаёт изображение, другая может готовить описание следующей задачи. В проверке из десяти заданий это сократило время всей серии с 26 минут 4 секунд до 23 минут 11 секунд — примерно на 11%. Все десять итоговых PNG совпали побайтово с последовательным запуском.
Выигрыш относится к полному циклу этой серии: подготовка следующей задачи частично совмещается с текущей генерацией.
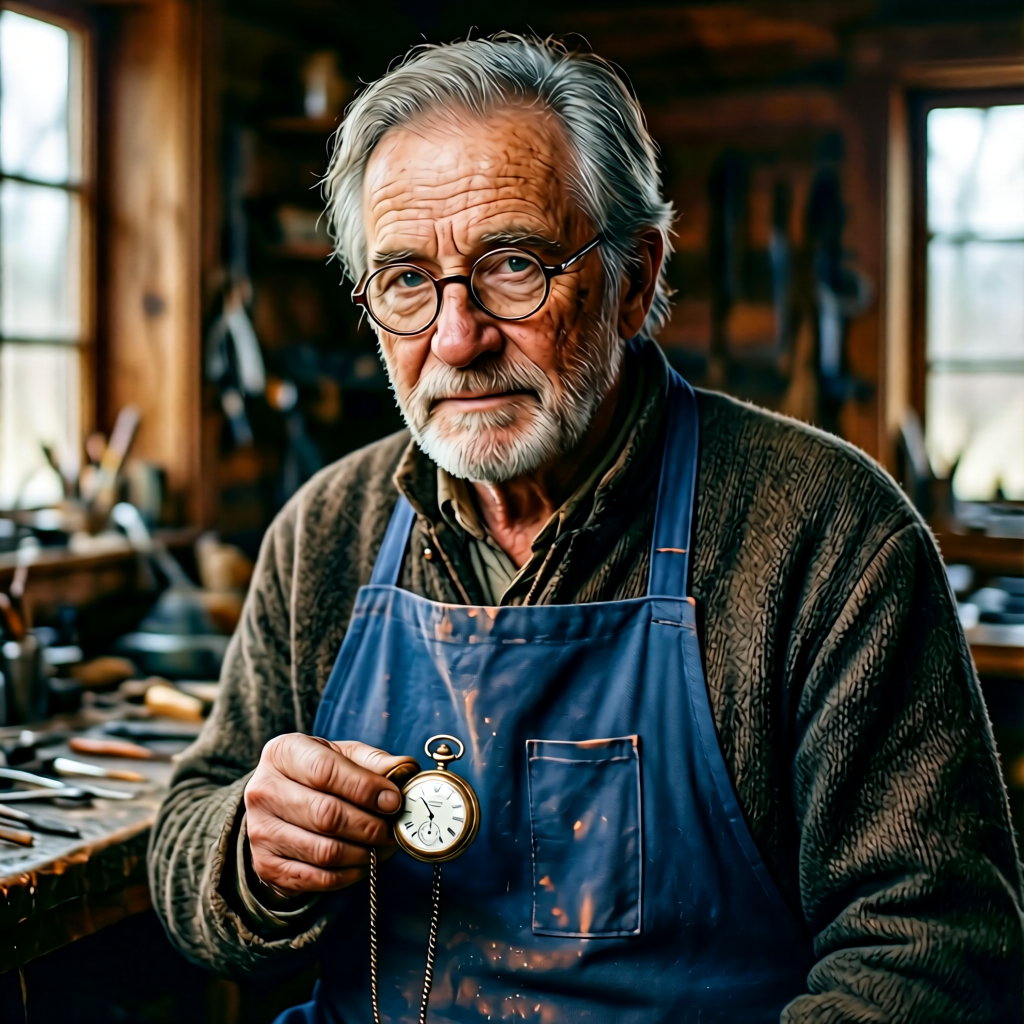
В другом опыте с моделью редактирования кэширование сократило медианное время примерно со 103 до 81 секунды. На всех трёх контрольных изображениях появились заметные дефекты. Этот режим отклонили.
Оба опыта повлияли на выбор настроек: полезно сокращать ожидание, сохраняя пригодность результата. Для этого в отчёте остаются и удачные, и отклонённые варианты.
 Без кэша
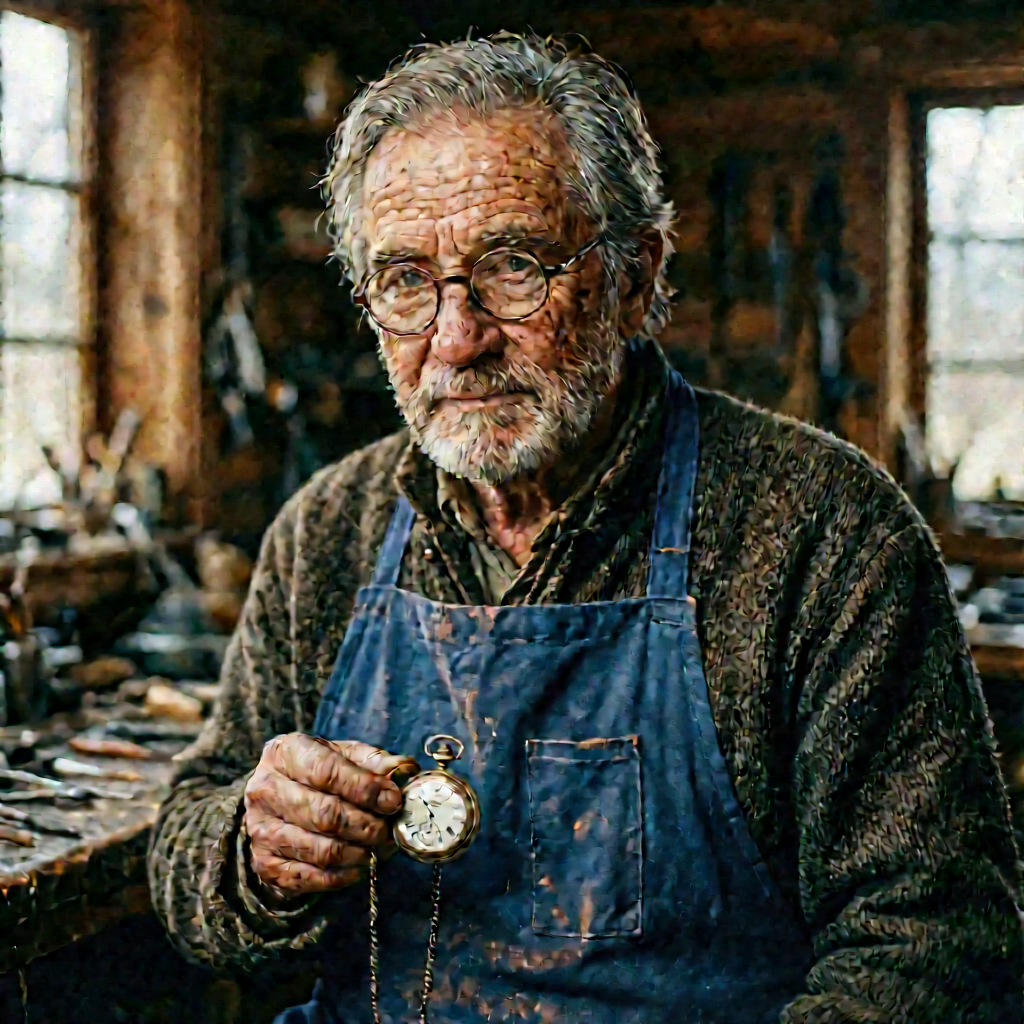 С EasyCache
17 ноября выполнили две группы по десять одинаковых заданий: шесть генераций и четыре правки. В первой группе подготовка и генерация шли последовательно. Во второй подготовка следующего описания совмещалась с созданием текущего изображения.
Полное время составило 1564,113 и 1391,017 секунды соответственно. Разница — 173,096 секунды, или 11,07% времени первой группы. Во всех десяти парах совпали описания и полные PNG-файлы.
Группы выполнялись в порядке «последовательно → с совмещением». Результат относится к этому набору и режиму работы; он не определяет скорость любой отдельной генерации или системы при произвольном числе пользователей.
15 ноября проверяли EasyCache в отдельном режиме Qwen Edit. На трёх контрольных заданиях медианное время уменьшилось со 103,173 до 80,596 секунды — на 21,88%. При визуальном сравнении все три результата показали заметные дефекты.
Для этих заданий экономия времени сопровождалась неприемлемым ухудшением изображения. Режим отклонили; этот опыт относится к конкретной модели и настройкам.
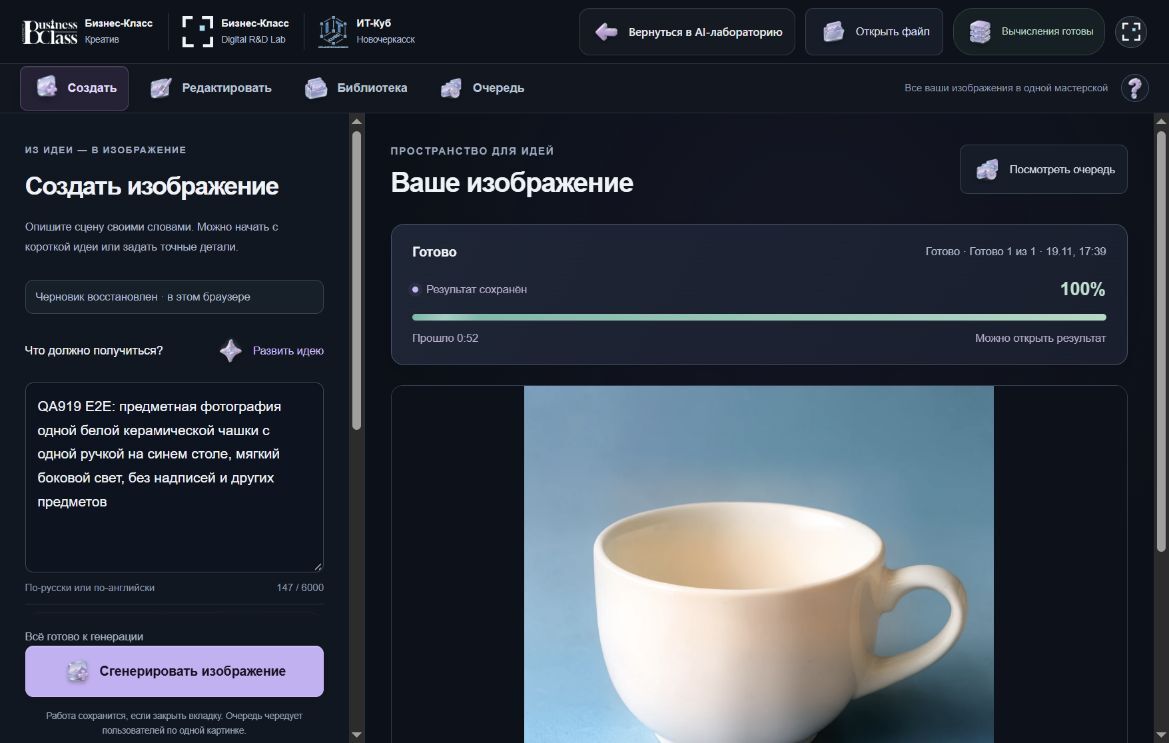
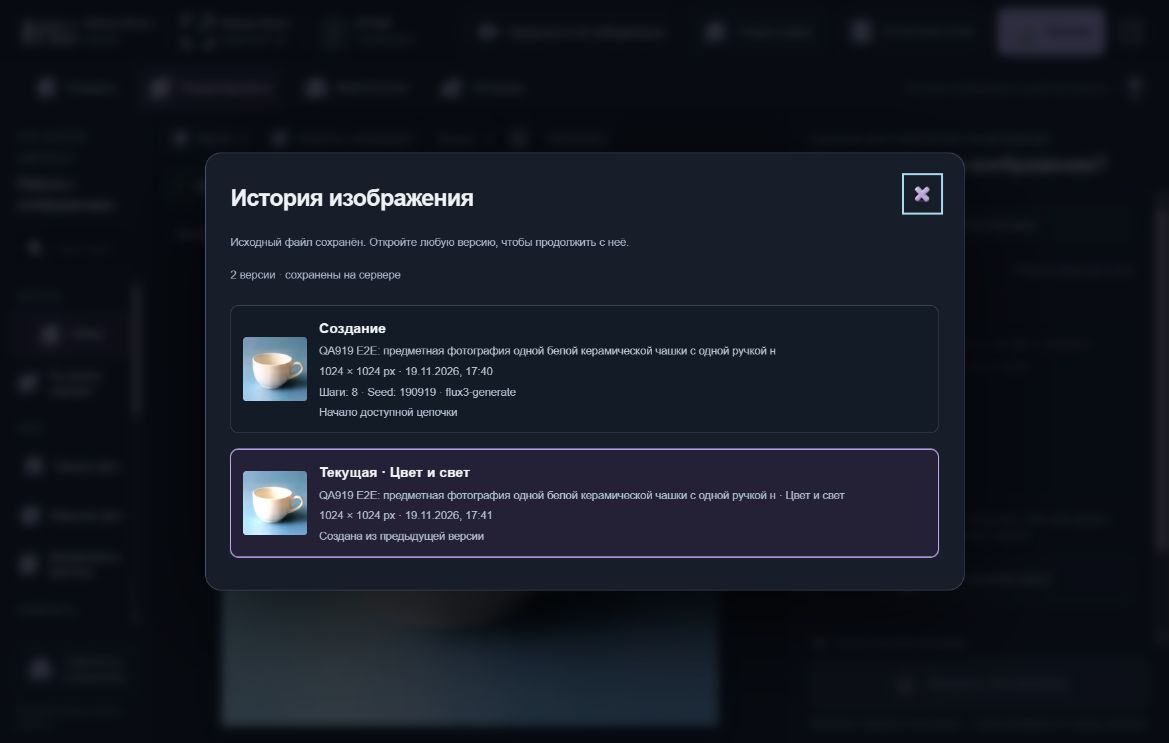
Studio объединяет действия, которые раньше выполнялись отдельными запусками. Пользователь описывает идею, при необходимости добавляет референс, ставит задачу в очередь и получает изображение в библиотеке. Затем можно продолжить работу с ним и сохранить новую версию.
| Задача | Что можно сделать |
|---|---|
| Создать изображение | Задать описание, параметры и референсы |
| Развить идею | Получить расширенный вариант запроса, просмотреть его и применить |
| Изменить изображение | Описать генеративную правку или выполнить точную операцию редактора |
| Подготовить материал | Удалить фон или увеличить изображение |
| Сохранить ход работы | Использовать библиотеку, коллекции и историю версий |
| Получить файл | Сравнить версии и экспортировать результат в PNG |
У точной и генеративной правки разные задачи. Изменение яркости применяется к существующим пикселям; правка по описанию заново интерпретирует изображение моделью и может затронуть соседние детали. В Studio эти способы работы разделены.
Один из проверенных маршрутов: создать изображение чашки, повысить яркость до 115%, сохранить вторую версию, сравнить её с исходником и скачать PNG. Исходник сохранился, а экспортированный файл совпал с сохранённой новой версией.
В ходе отладки также исправили ложное сообщение о потере ответа после сохранения. Исправление проверили отдельной операцией: сохранилась одна версия без повторного задания.
Studio доступна участникам с авторизацией. Это рабочий инструмент проекта; доступ для демонстрации согласуется отдельно.
Точная операция редактора применяет определённое преобразование к пикселям: например, изменяет яркость. Генеративная правка использует модель и текстовое описание, поэтому результат нужно проверять, включая детали вокруг изменяемой области. История версий помогает сравнить варианты и сохранить исходник.
При недоступной ноде интерфейс допускает ограниченную локальную подготовку. Вычислительные действия, которым нужны модели на GPU, требуют доступной ноды. Возможности библиотек и хранения также связаны с серверной частью системы.
Studio работает с авторизацией участников проекта. Чтобы обсудить демонстрацию или задачу для исследования, можно связаться с «Бизнес-Классом» через контакты на сайте.
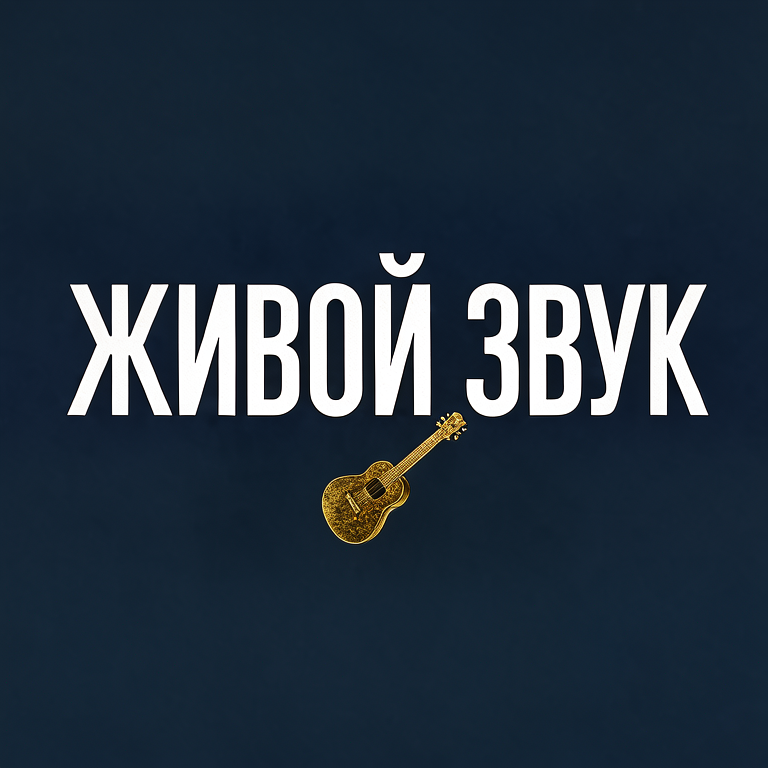 Исходная модель
 С адаптером LoRA
Следующий вопрос — можно ли адаптировать модель под собственную задачу. Для первого опыта подготовили 320 обучающих типографических примеров и 64 отдельных проверочных. Обучили небольшой дополнительный набор весов — LoRA — и проверили его подключение к генератору.
Обучение завершило 320 шагов. Для сравнения создали шесть пар изображений: исходная модель и та же модель с адаптером, с одинаковыми заданиями и начальными случайными значениями внутри каждой пары.
На четырёх заданиях с текстом целевые надписи оказались правильными в обоих вариантах. Среди них — «ЖИВОЙ ЗВУК». Технический путь обучения и подключения адаптера сработал, а улучшение кириллицы на этой проверке доказать не удалось. Итоговый набор оказался слишком простым для такой оценки. Адаптер остался экспериментальным.
В пилоте использовали и автоматическое распознавание текста. Его ошибки пришлось учитывать при оценке изображений. Следующий опыт требует более широкого независимого набора: известных сложных случаев и обычных задач, с заранее заданными метриками и проверкой спорных результатов человеком.
Набор кириллицы включал 320 обучающих и 64 проверочных примера. Проверочные примеры не участвовали в расчёте обучающей ошибки. Четыре целевые надписи итогового сравнения отсутствовали в обучающем наборе.
После 320 шагов подключили адаптер к генератору и получили 12 изображений — шесть пар. Четыре пары проверяли текст, две — обычные сюжеты. Визуально все четыре целевые надписи верны уже у исходной модели и остаются верными с LoRA. На этих примерах прирост качества установить не удалось.
Обучение выполнялось на недистиллированном FLUX 3 Base, а итоговые пары получены в рабочем distilled-генераторе с перенесённым адаптером. Так проверили сквозной перенос в пользовательскую цепочку. Это не чистое сравнение качества обученного Base до и после LoRA.
Количество примеров, шагов и пар сравнения описывает разные части опыта. Пилот подтвердил техническое выполнение; для оценки качества нужен отдельный протокол.
Да. В пилоте 22 ноября использовали Tesseract и считали точное совпадение текста и CER - долю вставок, удалений и замен символов относительно эталона. На четырёх текстовых заданиях OCR дал 3 из 4 точных совпадений для исходной модели и 2 из 4 с LoRA; при визуальной проверке все четыре надписи были правильны в обоих вариантах.
Сам распознаватель проверили на 64 правильных контрольных изображениях. Точно распознаны 46 из 64, CER составил 0,07325. На сценах OCR добавлял символы из фактур, рамок и предметов. Поэтому изменение автоматического балла не приняли за доказанную регрессию модели.
Сначала нужно разделить проверку обучения на исходном Base и перенос адаптера в рабочий distilled-генератор. Затем подготовить два независимых набора: диагностические случаи с известными ошибками и обычные задачи, отобранные до просмотра результатов адаптера. Это позволит оценить и сложные случаи, и сохранность прежних возможностей.
Предлагаемый масштаб - несколько сотен заданий с заранее выбранными seeds. До запуска следует закрепить эталонные строки, версии моделей и OCR, правила выделения текста, регистр, пробелы и обработку «Е/Ё». Метрики - точное совпадение и CER; спорные случаи проверяются человеком без подсказки, какой вариант показан. OCR дополнительно калибруется на правильных изображениях, близких к тестовым сценам.
Это план следующего исследования. Новые обучение, генерации и оценка по нему ещё не выполнялись; число 64 относится к прежнему проверочному набору, а не к 64 контрольным генерациям пилота.
Плановый ориентир вычислительной ноды
Состав и границы расчёта ↓Ориентир бюджета аппаратной части на ноябрь 2026 года.
В этот ориентир входят две видеокарты, плата, процессор, 48 ГБ памяти, накопители, питание, райзер и оборудование стенда. При повторении сборки итог зависит от состояния и наличия комплектующих, выбора новых деталей и предложений вторичного рынка.
Существующий ML350 с интерфейсом и хранением, разработка и настройка ПО, электричество и обслуживание считаются отдельно. Здесь показана стоимость вычислительной ноды.
Такой масштаб бюджета позволяет рассматривать локальную графическую систему как практический исследовательский инструмент. Начать знакомство с ИИ можно и через общий ресурс лаборатории; собственный стенд имеет смысл, когда понятны задачи и ожидаемая загрузка.
Аппаратная часть ноды: две RX 6900 XT по 16 ГБ, ASUS PRIME B365-PLUS, Pentium Gold G5420, 48 ГБ DDR4, SSD 240 ГБ, HDD 500 ГБ, блок питания, ленточный райзер, стенд и охлаждение.
Это ориентир бюджета на ноябрь 2026 года. Стоимость конкретной покупки зависит от состояния деталей, наличия и доставки. Существующий сервер ML350, сеть и ИБП, периферия, работа по сборке и ПО, электричество и обслуживание учитываются отдельно.
Для денежного расчёта нужно знать загрузку системы и расходы, которые она действительно позволяет сократить на сопоставимых задачах. Из этой экономии вычитают электричество, обслуживание и администрирование. Стоимость вложений делят на положительный месячный остаток.
Для этого стенда срок окупаемости пока не рассчитан. На данном этапе он даёт исследовательский результат: проверенные режимы, работающий инструмент и материалы для следующих опытов.
К 22 ноября собрана графическая нода, проверены режимы генерации и редактирования, создан интерфейс для работы с результатами и завершён первый опыт обучения. В материалах этапа сохранены исходные задания, сравнения и решения, принятые после испытаний.
Дальше — проверка на реальных задачах пользователей, более сложные тесты кириллицы и подготовка части опытов для повторения в ИТ-Кубе. Для каждого опыта важны понятное задание и результат, который можно показать и объяснить.
Локальная система даёт возможность пройти весь этот путь на собственном оборудовании: от идеи до изображения, от ошибки до следующего эксперимента.